gemini-3
Gemini 3: Wann lohnt sich Context Caching?
Gemini3 Team · 14. Oktober 2026 · 7 min read
Keywords: Gemini 3 Caching, Gemini API Kostenoptimierung, Context Caching Strategie, Implizites vs explizites Caching, Prompt Engineering
Published: 14. Oktober 2026 Author: Gemini3 Team
Wiederholte Eingaben sind das Signal zur Untersuchung
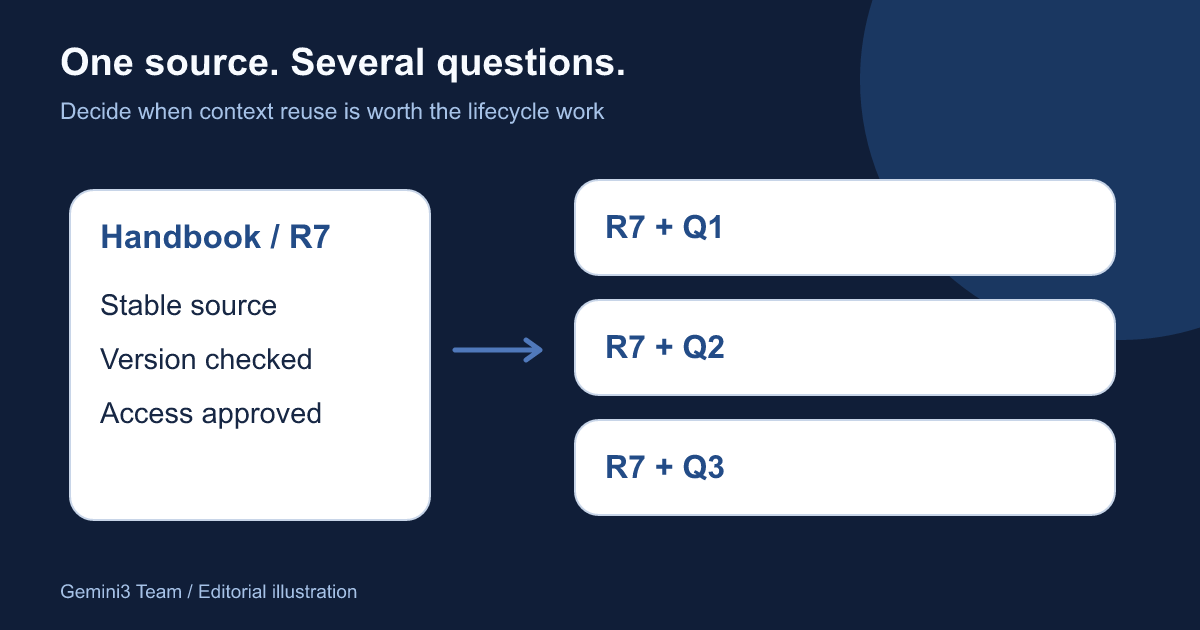
Angenommen, Ihr Team stellt zwanzig verschiedene Fragen zum selben Produkthandbuch. Das vollständige Handbuch bei jeder Anfrage zu senden, kann eine große Menge an Eingaben wiederholen. Context Caching lohnt sich zu prüfen, wenn das geteilte Material umfangreich, stabil und wiederverwendet wird. Es ist weniger überzeugend, wenn jede Anfrage ein anderes kurzes Dokument verwendet.
Dieser Leitfaden bietet einen Entscheidungsprozess für Gemini API-Nutzer, mit einem originalen Handbuch-Szenario und redaktionellen Diagrammen. Er berichtet nicht über gemessene Einsparungen, verspricht keine schnelleren Antworten oder beschreibt einen Cache-Schalter innerhalb von MidassAI Chat. Ein Chat-Dienst eines Drittanbieters kann sein eigenes Kontextmanagement implementieren; überprüfen Sie dessen dokumentiertes Verhalten separat.
Wählen Sie zuerst die API, die Sie tatsächlich nutzen. Googles aktuelle Dokumentation zum Interactions-Caching beschreibt implizites Caching. Die Dokumentation zum generateContent-Caching beschreibt ebenfalls explizite Cache-Objekte für unterstützte Gemini 3 und 2.5 Modelle. Kopieren Sie keine Anweisungen für explizite Caches in eine Interactions-Integration.
Was sollte zwischen den Fragen gleich bleiben?
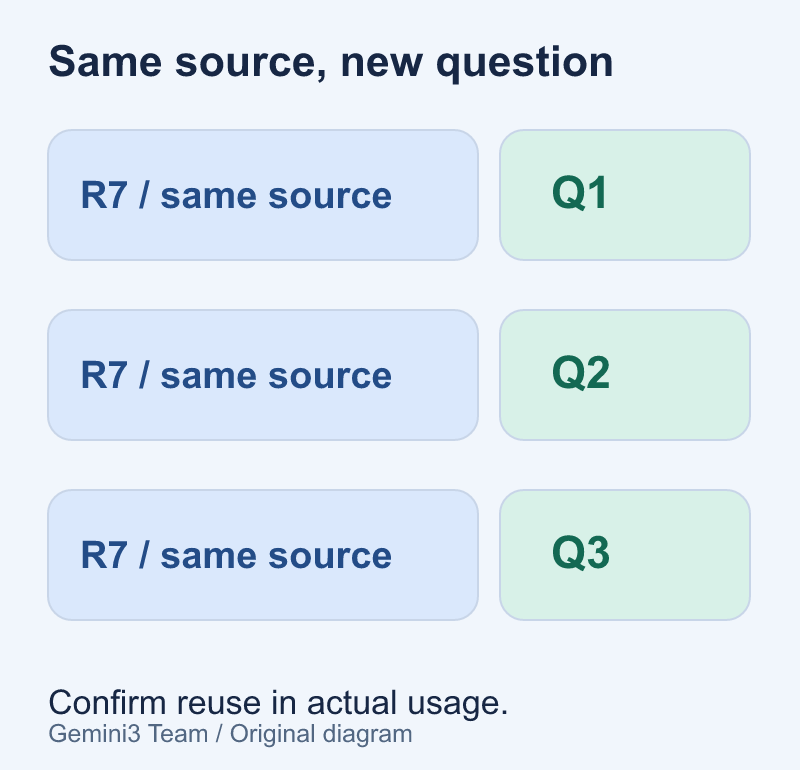
In der Abbildung ist der blaue Block dieselbe Handbuchrevision. Die drei kleineren Blöcke sind verschiedene Fragen. Dies ist das Muster, nach dem Sie suchen sollten: gemeinsames Material zuerst, aufgabenspezifisches Material danach. Das Diagramm erklärt die Anfrageorganisation, keine Garantie, dass eine Anfrage einen impliziten Cache trifft.
Ein effektiver geteilter Kontext ist ein bewusstes Paket: der Handbuchtext, eine Versionskennung und die Anweisungen, die tatsächlich für jede Frage gelten. Vermeiden Sie es, einen sich ändernden Zeitstempel, eine zufällige Kennung oder eine irrelevante Begrüßung vor das stabile Material zu stellen. Behalten Sie Anwendungs-Logging-Kennungen außerhalb des Modellinputs, wenn sie keinem Zweck für die Verarbeitung dienen.
Bevor Sie optimieren, beantworten Sie drei Fragen. Ändert sich die Quelle während der Session? Hat jeder Nutzer die Berechtigung, das gesamte Paket zu verwenden? Kann Ihre Anwendung jede Antwort auf die Quellenrevision zurückverfolgen? Wenn eine Antwort unklar ist, beheben Sie die Quellenauswahl und Zugriffskontrollen, bevor Sie versuchen, wiederholte Tokens zu reduzieren.
Zwei Mechanismen, unterschiedliche Zuständigkeiten
| Frage | Implizites Caching | Explizites Caching |
|---|---|---|
| Wer verwaltet das Cache-Objekt? | Kein Objekt in Ihrer Anwendung zu erstellen | Ihre Anwendung erstellt und referenziert einen Cache |
| Wird Wiederverwendung durch einen ähnlichen Prompt garantiert? | Nein; prüfen Sie die tatsächliche Nutzung | Überprüfen Sie die Cache-Referenz und die zurückgegebene Nutzung |
| Welcher API-Pfad ist hier relevant? | Folgen Sie dem Caching-Leitfaden der aktuellen API | Verwenden Sie unterstützte generateContent-Modelle und -Methoden |
| Was müssen Sie planen? | Stabile gemeinsame Präfixe und Messung | Quellversionen, Ablauf, Bereinigung und Gesamtkosten |
Googles Dokumentation besagt, dass implizites Caching standardmäßig für Gemini 2.5 und neuere Modelle aktiviert ist, vorbehaltlich modellspezifischer Eingabeschwellenwerte. Es empfiehlt, gemeinsames Material früh zu platzieren und ähnliche Präfixe nahe beieinander zu senden. Der Schwellenwert ist eine Token-Anzahl, keine Wortanzahl oder Dateigrößenschätzung. Schlagen Sie das exakte unterstützte Modell nach, statt anzunehmen, dass jede Gemini 3-Variante identische Limits hat.
Explizites Caching fügt Verwaltungsaufwand hinzu. Der aktuelle generateContent-Leitfaden beschreibt eine standardmäßige TTL von einer Stunde, wenn keine Dauer angegeben ist, und unterscheidet zwischen gespeicherter Token-Dauer und Cached-Input sowie anderen Anfragegebühren. Dies sind API-Verhaltensweisen, keine Garantie für Ihre endgültige Rechnung. Überprüfen Sie die relevante Modell- und API-Dokumentation vor der Implementierung erneut.
Eine Handbuch-Session mit einem klaren Ende
Hier ist ein reproduzierbares Planungsbeispiel, kein aufgezeichnetes Produktions-Experiment. Das Team hat Handbuchrevision 7, erwartet eine kurze Review-Session und möchte Antworten auf drei Fragen: was sich im Onboarding änderte, welche Ausnahmen Genehmigung benötigen und wo das Eskalationsverfahren erscheint.
Für implizites Caching organisieren Sie jede Anfrage um dasselbe stabile Quellenpräfix und variieren die Frage danach. Protokollieren Sie die zurückgegebene Nutzung für jede Antwort. Ähnlicher Input ist eine Gelegenheit zur Wiederverwendung; nur die tatsächliche Nutzung kann Ihnen sagen, was passiert ist.
Für explizites Caching in einer unterstützten generateContent-Integration:
- Bereiten Sie eine saubere, genehmigte Handbuchrevision vor und zählen Sie ihre Tokens mit dem geeigneten Tooling.
- Überprüfen Sie die Cache-Unterstützung und Limits des Modells, bevor Sie eine Ressource erstellen.
- Erstellen Sie einen Cache mit einer bewusst gewählten Lebensdauer und speichern Sie seine Kennung, das Modell und die Quellenrevision.
- Referenzieren Sie diesen Cache für die Fragen und halten Sie das ausgewählte Modell konsistent mit dem Cache.
- Protokollieren Sie die zurückgegebene Nutzung und überprüfen Sie die Antworten gegen das Handbuch.
- Löschen Sie den Cache, wenn die Review endet, oder lassen Sie das gewählte Ablaufdatum die geplante Lebensdauer handhaben.
Die Anwendung muss diese Schritte implementieren; ein Prompt in natürlicher Sprache kann einen Cache nicht allein erstellen oder verwalten. Behalten Sie API-Zugangsdaten auf dem Server und außerhalb von Artikeln, client-seitigem Code und Analytics-Logs.
Versionsänderungen erfordern eine neue Entscheidung
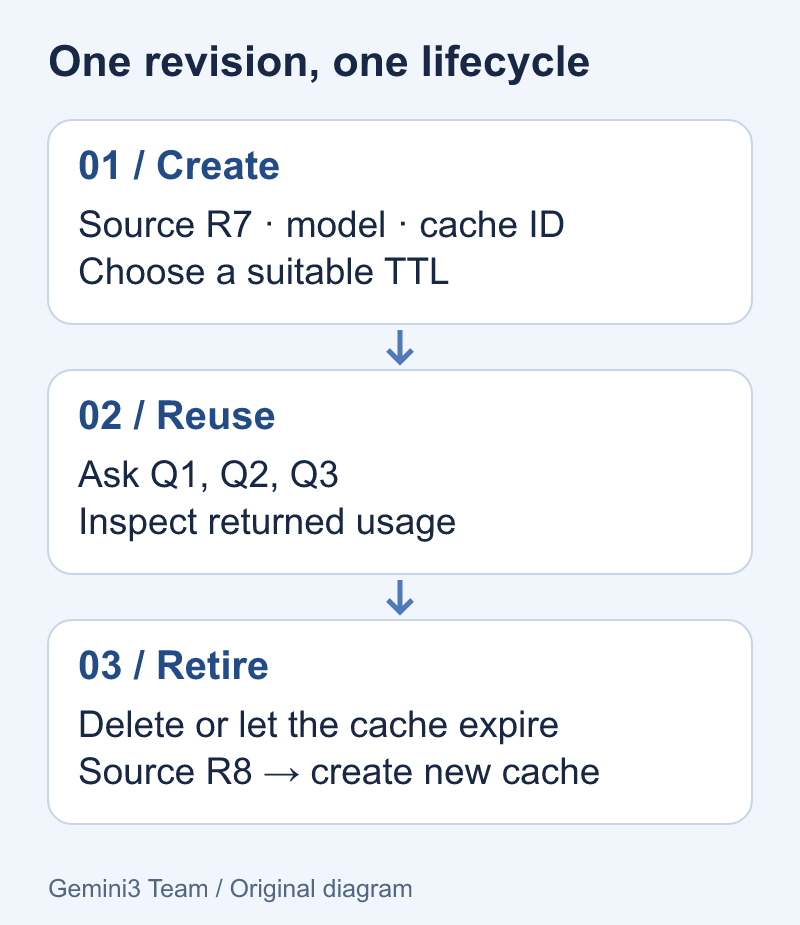
Die Lifecycle-Illustration zeigt eine Revisionsänderung als Verzweigung, nicht als In-Place-Inhaltsbearbeitung. Googles generateContent-Leitfaden erlaubt das Aktualisieren von Ablauf oder TTL, aber nicht des gecachten Inhalts selbst. Wenn Handbuchrevision 8 die Antwort ändert, erstellen Sie einen neuen genehmigten Kontext und leiten Sie keine neuen Fragen mehr an die alte Revision weiter.
Ein nützlicher Anwendungsdatensatz verknüpft die Cache-Kennung mit einer Quellen-Checksumme, dem exakten Modell, der Erstellungszeit, dem Ablauf und dem Zugriffsbereich. Dies ist eine Buchführungsempfehlung für die Anwendung, keine Liste von Feldern, die von der Gemini API versprochen werden. Nehmen Sie nie an, dass ein lesbarer Anzeigename das richtige Dokument eindeutig identifiziert.
Trennen Sie auch die Cache-Bereinigung von der Dokumentenaufbewahrung. Das Löschen eines Caches ist kein Beweis dafür, dass jede hochgeladene Quelldatei, lokale Kopie oder Log gelöscht wurde. Wenden Sie Ihre eigenen Aufbewahrungsregeln auf jeden Standort an. Die Dokumentation erlaubt das Abrufen von Cache-Metadaten, nicht das Zurücklesen des gespeicherten Inhalts als Dokumentenarchiv, daher behalten Sie Ihre maßgebliche Quelle unter Ihren bestehenden Kontrollen.
Vergleichen Sie die gesamte Arbeitslast, nicht eine attraktive Zahl
Verwenden Sie einen kleinen Bewertungsbogen, bevor Sie entscheiden, ob Sie einen expliziten Cache behalten wollen. Halten Sie die Quellenrevision, Fragen und das Modell konstant. Protokollieren Sie die Session-Dauer und die tatsächliche Nutzung, statt einen Rabattprozentsatz zu erfinden.
| Messwert | Warum es wichtig ist |
|---|---|
| Exakte API, Modell und Quellenrevision | Hält zwei Versuche vergleichbar |
| Anzahl der tatsächlich gestellten Fragen | Misst Wiederverwendung statt erwarteter Nachfrage |
| Gecachte und nicht gecachte Eingaben | Zeigt, wo Wiederverwendung stattfand |
| Ausgabevolumen | Das Cachen der Eingabe ersetzt nicht die Erzeugung der Ausgabe |
| Cache-Lebensdauer und Speichergebühren | Lange Leerlaufzeiten können das Ergebnis verändern |
| Antwortprüfungen und Fehler | Niedrigere Kosten sind nicht nützlich, wenn die falsche Revision antwortet |
Berechnen Sie die Summe mit den aktuellen Abrechnungsbedingungen für Ihr Konto, Modell und API. Schließen Sie Cache-Erstellungs- oder Input-Verarbeitungsgebühren ein, wo zutreffend, Speicherdauer, nicht gecachte Frage-Tokens und generierten Output. Vergleichen Sie diese Summe mit derselben Arbeitslast ohne einen explizit verwalteten Cache. Implizite Wiederverwendung kann auch die Baseline beeinflussen, daher bezeichnen Sie eine Baseline nicht als "uncached", ohne ihre tatsächliche Nutzung zu prüfen.
Dieser Artikel liefert bewusst keine aktuelle Preistabelle: Preisgestaltung und Modellverfügbarkeit können sich unabhängig vom Workflow ändern. Nutzen Sie die offizielle Preisseite für die Beträge, die gelten, wenn Sie Ihre Evaluation durchführen.
Erkennen Sie, wann Caching der falsche nächste Schritt ist
Eine einzelne Kurzfrage, ein sich ständig änderndes Quellenpaket oder ein Projekt ohne eine zuverlässige Dokumentversionszuordnung kann mehr von einer besseren Input-Auswahl profitieren. Entfernen Sie irrelevante Seiten, teilen Sie unabhängige Aufgaben und testen Sie zuerst die Antwortqualität. Polstern Sie einen Prompt nicht lediglich auf, um einen Cache-Schwellenwert zu überschreiten; das verändert die Arbeitslast und kann den Zweck der Optimierung zunichtemachen.
Wenn ein Cache mitten in der Session abläuft, behandeln Sie den Fehler explizit. Laden Sie die beabsichtigte Quellenrevision neu und erstellen Sie die Ressource nur dann neu, wenn die verbleibende Arbeit es rechtfertigt. Ersetzen Sie nicht stillschweigend ein anderes Dokument oder versuchen Sie nicht weiter, dieselbe abgelaufene Referenz zu nutzen. Bewahren Sie die Frage auf, damit der Nutzer die Arbeit fortsetzen kann, ohne zu raten, was verloren ging.
Schließlich wiederverwendet Caching Input; es validiert nicht die Antwort oder erhöht das Kontextfenster über die Limits des Modells hinaus. Für Outputs, die ein anderes Programm konsumieren muss, paaren Sie den Wiederverwendungsplan mit einem strukturierten Output-Validierungs-Workflow. Eine gut organisierte Quelle und ein geprüftes Ergebnis lösen verschiedene Teile desselben Zuverlässigkeitsproblems.