gemini-3
Gemini 3 : quand mettre le contexte en cache ?
Gemini3 Team · 14 octobre 2026 · 9 min read
Keywords: cache contexte Gemini, optimisation API Gemini, gestion révision document
Published: 14 octobre 2026 Author: Gemini3 Team
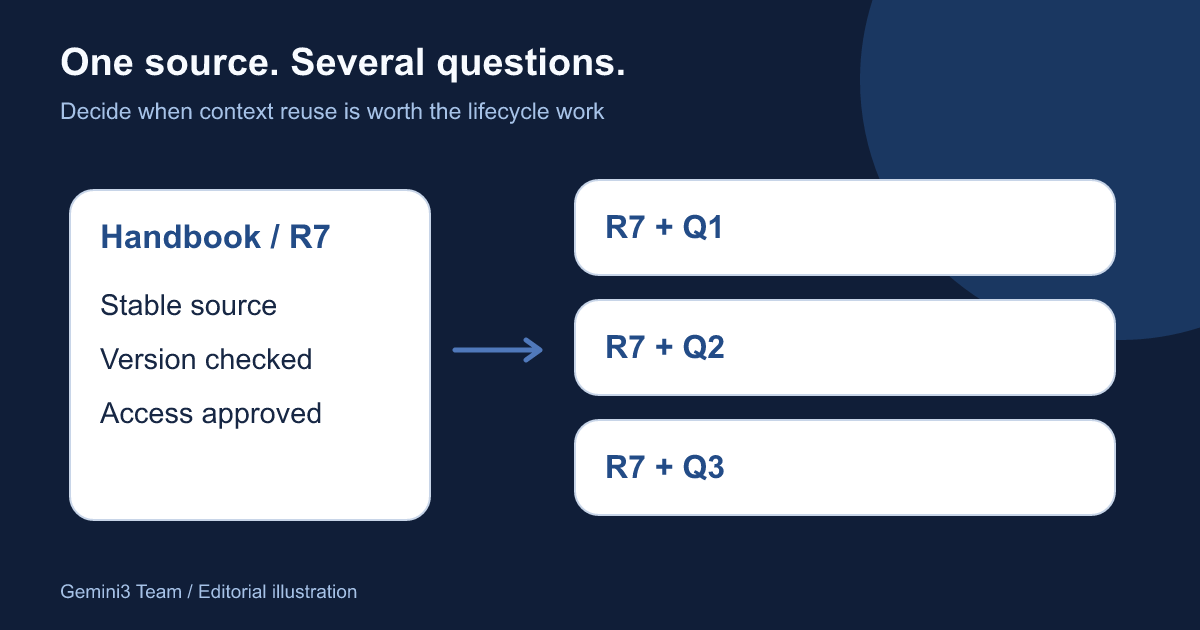
Les entrées répétées sont le signal à examiner
Supposez que votre équipe pose vingt questions différentes sur le même manuel produit. Envoyer le manuel complet avec chaque demande peut répéter une grande quantité d’entrée. La mise en cache du contexte vaut la peine d'être étudiée lorsque le matériel partagé est substantiel, stable et réutilisé. Elle est moins convaincante lorsque chaque demande utilise un document court différent.
Ce guide propose un processus de décision pour les utilisateurs de l'API Gemini, avec un scénario de manuel original et des diagrammes éditoriaux. Il ne rapporte pas d'économies mesurées, ne promet pas de réponses plus rapides et ne décrit pas un commutateur de mise en cache dans MidassAI Chat. Un service de chat tiers peut implémenter sa propre gestion de contexte ; vérifiez son comportement documenté séparément.
Choisissez d'abord l'API que vous utilisez réellement. La documentation de mise en cache Interactions actuelle de Google décrit la mise en cache implicite. Sa documentation de mise en cache generateContent décrit également les objets de cache explicites pour les modèles Gemini 3 et 2.5 pris en charge. Ne copiez pas les instructions de cache explicite dans une intégration Interactions.
Que doit rester identique entre les questions ?
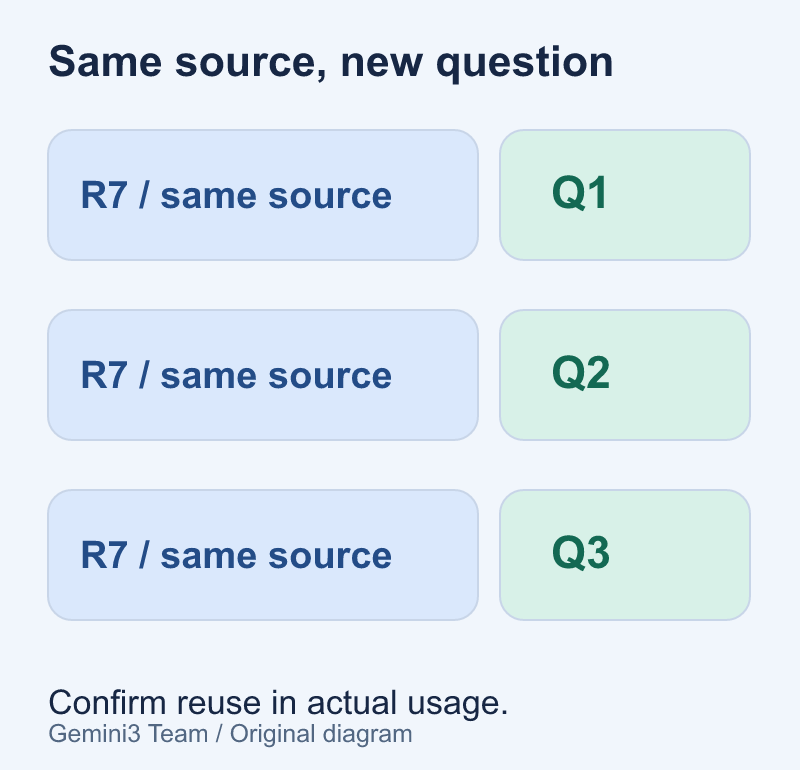
Dans l'illustration, le bloc bleu est la même révision du manuel. Les trois petits blocs sont des questions différentes. C'est le motif à rechercher : matériel commun d'abord, matériel spécifique à la tâche ensuite. Le diagramme explique l'organisation des demandes, pas une garantie qu'une demande utilisera un cache implicite.
Un contexte partagé efficace est un paquet délibéré : le texte du manuel, un identifiant de version et les instructions qui s'appliquent réellement à chaque question. Évitez de placer un horodatage changeant, un identifiant aléatoire ou une salutation sans rapport devant le matériel stable. Conservez les identifiants de journalisation d'application en dehors de l’entrée du modèle lorsqu'ils ne servent aucun objectif de raisonnement.
Avant d'optimiser, répondez à trois questions. La source change-t-elle pendant la session ? Chaque utilisateur a-t-il la permission d'utiliser le paquet entier ? Votre application peut-elle tracer chaque réponse jusqu'à la révision source ? Si une réponse est peu claire, corrigez la sélection de source et les contrôles d'accès avant d'essayer de réduire les tokens répétés.
Deux mécanismes, des responsabilités différentes
| Question | Mise en cache implicite | Mise en cache explicite |
|---|---|---|
| Qui gère l'objet cache ? | Aucun objet à créer dans votre application | Votre application crée et référence un cache |
| La réutilisation est-elle garantie par un prompt similaire ? | Non ; inspectez l'usage réel | Vérifiez la référence du cache et l'usage retourné |
| Quel chemin API importe ici ? | Suivez le guide de mise en cache de l'API actuelle | Utilisez les modèles et méthodes generateContent pris en charge |
| Que devez-vous planifier ? | Préfixes partagés stables et mesure | Versions source, expiration, nettoyage et coût total |
La documentation de Google indique que la mise en cache implicite est activée par défaut pour les modèles Gemini 2.5 et plus récents, sous réserve de seuils d’entrée spécifiques au modèle. Elle recommande de placer le matériel commun tôt et d'envoyer des préfixes similaires proches les uns des autres. Le seuil est un nombre de tokens, pas un nombre de mots ou une estimation de taille de fichier. Recherchez le modèle pris en charge exact au lieu de supposer que chaque variante Gemini 3 a des limites identiques.
La mise en cache explicite ajoute un travail de cycle de vie. Le guide generateContent actuel décrit un TTL par défaut d'une heure lorsqu'aucune durée n'est spécifiée, et distingue la durée des tokens stockés des frais d’entrée mis en cache et d'autres frais de demande. Ce sont des comportements API, pas une garantie concernant votre facture finale. Revérifiez la documentation du modèle et de l'API pertinente avant l'implémentation.
Une session de manuel avec une fin claire
Voici un exemple de planification reproductible, pas une expérimentation de production enregistrée. L'équipe dispose de la révision 7 du manuel, attend une courte session de révision et veut des réponses à trois questions : ce qui a changé dans l'onboarding, quelles exceptions nécessitent une approbation et où apparaît la procédure d'escalade.
Pour la mise en cache implicite, organisez chaque demande autour du même préfixe source stable et variez la question ensuite. Enregistrez l'usage retourné pour chaque réponse. Une entrée similaire est une opportunité de réutilisation ; seul l'usage réel peut vous dire ce qui s'est passé.
Pour la mise en cache explicite sur une intégration generateContent prise en charge :
- Préparez une révision de manuel propre et approuvée et comptez ses tokens avec l'outillage approprié.
- Vérifiez la prise en charge du cache et les limites du modèle avant de créer une ressource.
- Créez un cache avec une durée de vie délibérément choisie et enregistrez son identifiant, son modèle et sa révision source.
- Référencez ce cache pour les questions, en gardant le modèle sélectionné cohérent avec le cache.
- Enregistrez l'usage retourné et examinez les réponses par rapport au manuel.
- Supprimez le cache lorsque la révision se termine, ou laissez l'expiration choisie gérer la durée de vie planifiée.
L'application doit implémenter ces étapes ; un prompt en langage naturel ne peut pas créer ou gérer un cache par lui-même. Conservez les clés API sur le serveur et en dehors des articles, du code côté client et des journaux d'analytique.
Les changements de version nécessitent une nouvelle décision
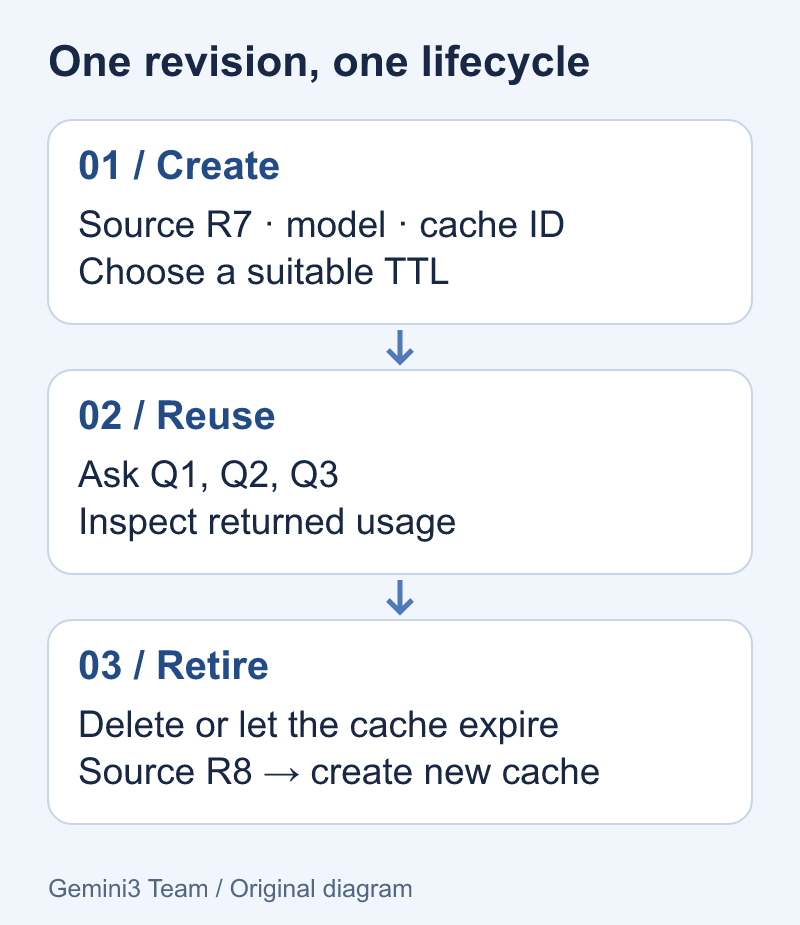
L'illustration du cycle de vie montre un changement de révision comme une branche, pas comme une édition de contenu sur place. Le guide generateContent de Google permet de mettre à jour l'expiration ou le TTL, mais pas le contenu mis en cache lui-même. Si la révision 8 du manuel change la réponse, construisez un nouveau contexte approuvé et arrêtez de router les nouvelles questions vers l'ancienne révision.
Un enregistrement d'application utile associe l'identifiant du cache à une somme de contrôle source, un modèle exact, une heure de création, une expiration et une portée d'accès. C'est une recommandation de comptabilité d'application, pas une liste de champs promis par l'API Gemini. Ne supposez jamais qu'un nom d'affichage lisible par l'homme identifie uniquement le bon document.
Séparez également le nettoyage du cache de la rétention des documents. Supprimer un cache n'est pas la preuve que chaque fichier source téléchargé, copie locale ou journal a été supprimé. Appliquez vos propres règles de rétention à chaque emplacement. La documentation permet de récupérer les métadonnées du cache, pas de lire le contenu stocké comme une archive de documents, donc gardez votre source de référence sous vos contrôles existants.
Comparez la charge de travail complète, pas un seul chiffre attractif
Utilisez une petite feuille d'évaluation avant de décider de conserver un cache explicite. Maintenez la révision source, les questions et le modèle constants. Enregistrez la durée de la session et l'usage réel plutôt que d'inventer un pourcentage de remise.
| Enregistrement | Pourquoi cela importe |
|---|---|
| API exacte, modèle et révision source | Rend deux essais comparables |
| Nombre de questions réellement posées | Mesure la réutilisation plutôt que la demande attendue |
| Usage d'entrée mis en cache et non mis en cache | Montre où la réutilisation a eu lieu |
| Usage de sortie | Capturer l'entrée ne supprime pas le travail de sortie |
| Durée de vie du cache et frais de stockage | De longues périodes d'inactivité peuvent changer le résultat |
| Vérifications des réponses et échecs | Un coût inférieur n'est pas utile si la mauvaise révision répond |
Calculez le total avec les conditions de facturation actuelles pour votre compte, modèle et API. Incluez la création de cache ou les frais de traitement d’entrée le cas échéant, la durée de stockage, les tokens de questions non mis en cache et la sortie générée. Comparez ce total avec la même charge de travail sans cache géré explicitement. La réutilisation implicite peut également affecter la base de référence, donc n'étiquetez pas une base de référence « non mise en cache » sans inspecter son usage réel.
Cet article ne fournit délibérément aucun tableau de prix actuel : les prix et la disponibilité des modèles peuvent changer indépendamment du flux de travail. Utilisez la page de tarification officielle pour les montants qui s'appliquent lorsque vous exécutez votre évaluation.
Reconnaître quand la mise en cache est la mauvaise prochaine étape
Une question courte unique, un ensemble de sources changeant constamment ou un projet sans carte de version de document fiable peuvent gagner davantage d’une meilleure sélection d’entrée. Supprimez les pages non pertinentes, divisez les tâches indépendantes et testez la qualité des réponses d'abord. Ne rembourrez pas un prompt simplement pour franchir un seuil de cache ; cela change la charge de travail et peut compromettre le but de l'optimisation.
Si un cache expire en cours de session, gérez l'échec explicitement. Rechargez la révision source prévue et recréez la ressource uniquement si le travail restant le justifie. Ne substituez pas silencieusement un autre document et ne continuez pas à réessayer la même référence expirée. Conservez la question pour que l'utilisateur puisse récupérer sans deviner ce qui a été perdu.
Enfin, la mise en cache réutilise l’entrée ; elle ne valide pas la réponse ni n'augmente la fenêtre de contexte au-delà des limites du modèle. Pour les sorties qu'un autre programme doit consommer, associez le plan de réutilisation avec un flux de travail de validation de sortie structurée. Une source bien organisée et un résultat vérifié résolvent différentes parties du même problème de fiabilité.